RAG · Qdrant · Flask · LLMs
Xerebro — RAG operativo
Asistente RAG en producción sobre los reportes operativos diarios del Sistema Nacional de Refinación. Responde en lenguaje natural citando la fuente, con failover automático entre LLMs.
290
días con reporte indexado
2,030
fragmentos en Qdrant
7
refinerías
● vía el servidor MCP de Xerebro · último reporte 17 de octubre de 2026 · se actualiza a diario
 ver en vivo
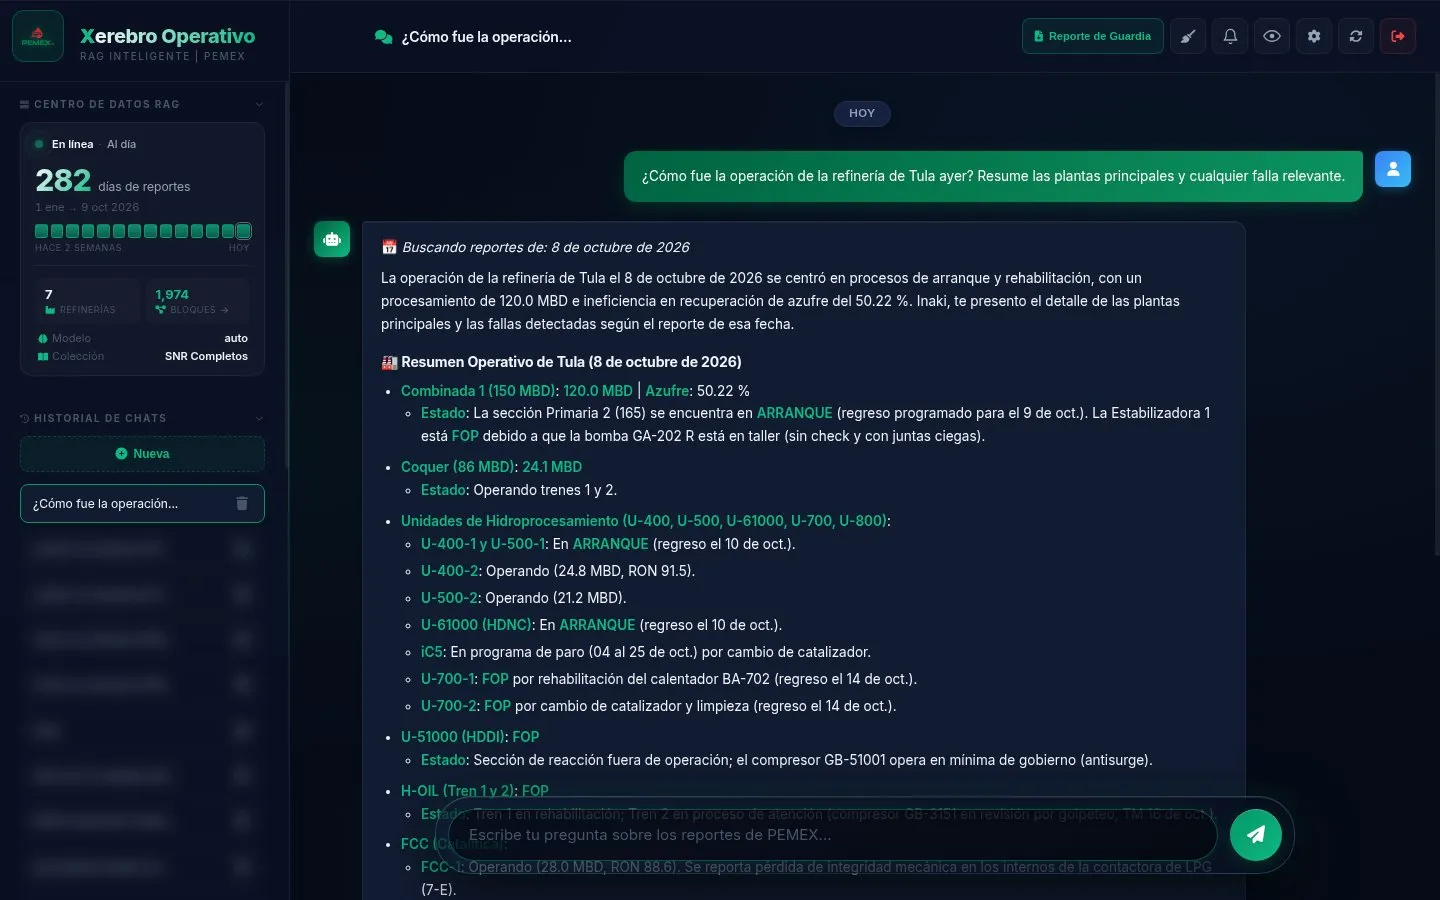
● página en vivo · inaki-vpn.asuscomm.comXerebro en producción. El acceso requiere cuenta porque es un sistema interno; la captura muestra una consulta real.
ver en vivoProblema
Las refinerías del Sistema Nacional de Refinación generan reportes operativos todos los días: cargas procesadas, fallas de equipo, paros y arranques. La información existe, pero encontrar “qué pasó con la bomba P-101 de Salina Cruz el 15 de agosto” significa abrir y leer reportes uno por uno. Y una respuesta de IA sin fuente no sirve en un entorno operativo: hay que poder comprobarla.
Solución
Xerebro es una plataforma RAG que responde preguntas técnicas y operativas en lenguaje natural, citando el reporte, la refinería, la fecha y el turno de donde sale cada dato. La diseñé, construí y la opero en producción: cada día se indexa el reporte de las siete refinerías, y las cifras de arriba vienen directo de su servidor MCP.
Antes de buscar, el sistema clasifica la intención de la pregunta para no gastar llamadas de más:
- Conceptual (“¿qué es la hidrodesulfuración?”): responde desde una base de conocimiento técnica (glosario, fichas de refinerías, reglas de negocio) sin tocar la base vectorial.
- Operativa (“¿cuántos barriles procesó Tula ayer?”): búsqueda semántica en Qdrant con pre-filtros de fecha, refinería y equipo.
- Híbrida: combina ambas fuentes.
Arquitectura
- Recuperación: embeddings de la pregunta y búsqueda en Qdrant, con interpretación determinística de fechas en lenguaje natural (“ayer”, “el lunes”, “15 de agosto”) y detección de equipos por etiqueta.
- Generación: una cascada de LLMs (Gemini, Groq, OpenRouter). Si un proveedor responde con error de cuota (429), entra en cooldown y la petición pasa al siguiente sin que el usuario lo note.
- Aplicación: Flask con streaming por SSE, autenticación con sesiones, historial por usuario respaldado en AWS S3 y avisos administrativos en tiempo real.
- Seguridad: rate limiting sobre SQLite en modo WAL, bloqueo temporal por IP ante intentos de fuerza bruta y filtros para bots.
- Operación: Docker, Gunicorn y Nginx con TLS en Linux.
Resultados
- En producción, con un reporte nuevo indexado cada día (cifras actualizadas arriba).
- 85 tests automatizados que corren sin red.
- Menos errores por cuota de los proveedores y menos consultas innecesarias a la base vectorial gracias al enrutamiento por intención.
Stack
Python, Flask, Qdrant, Gemini, Groq, OpenRouter, SQLite (WAL), AWS S3, Docker, Gunicorn, Nginx, Linux.
El código es privado por tratarse de un sistema interno; con gusto lo explico en una entrevista.